多市场选股别只算指标:用一套行情 API 串起扫描池、市场指标和资金流
TickDB Research ·
把A股策略扩展到港股和美股时,很多人第一反应是加指标。真正拖慢你的,往往是更早的数据准备:三份股票名单、不同的symbol规则,以及分散在不同入口里的行情、指标和资金流。
TickDB的优势就在这里:用同一套REST API接入A股、港股和美股。产品目录建立扫描池,ticker和K线确认行情,calc-index批量读取市场指标,capital-flow继续查看候选股票的资金流结构。
它不替你选股票,但能把选股前最容易断开的几层数据接起来。
扫描池决定看得见谁,市场指标决定先看谁,资金流补充候选对象的盘中结构。
先解决“谁会被看见”
一套选股或行情监控任务,至少有两层:
- 输入范围:看哪些市场、哪些股票,symbol从哪里来,名单是否仍然有效;
- 筛选规则:涨跌幅、量比、估值、资金流,以及自定义因子。
第二层再精巧,也补不上第一层的缺口。代码只会处理收到的名单,不会提醒你“外面还漏了一只”。
没有报错,只能说明名单内的股票被处理了,不能证明名单本身完整。
代码从不撒谎,但它也从不告密。
从A股扩到三地市场,真正麻烦的是名单
原来只做A股,现在加入港股和美股。最直觉的办法,是再找两份股票代码表,复制两套调用。
短期能跑,时间一长就会遇到三个问题:
- 三份名单来源不同、更新节奏不同,迟早不同步;
- 同一家公司在不同数据源里的symbol和类型规则可能完全不一样;
- 股票目录、实时价格、K线和辅助指标各走一套入口,还要自己补映射和路由。
结果不是一套多市场系统,而是三套逻辑拼在一起。每增加一个市场,就多维护一套“谁会被看见、看见后还能查到什么”的规则。
市场指标先筛,资金流再看
扫描池建好后,指标和资金流开始接棒。
TickDB提供两层辅助数据:
/v1/market/calc-index:批量返回多只股票的涨跌幅、量比、估值等市场指标,官方文档给出的单次上限为50只,适合初筛;/v1/market/capital-flow:查看单只股票的分钟资金流,以及大、中、小单的流入流出分布,适合候选对象的进一步观察。
一个批量扫,一个单只看。最终阈值、排序和买卖判断,仍由用户自己的规则决定。
用贵州茅台、腾讯控股和苹果跑一遍
本次实测选择了三个高认知标的:A股贵州茅台 600519.SH、港股腾讯控股 700.HK、美股苹果 AAPL.US。
检查链路是:
股票信息 → ticker → 1d历史K线 → 综合市场指标 → 资金流向
下面是实测脚本的核心调用。完整脚本另有API Key读取、HTTP状态、业务码、空数据检查和证据落盘。
symbols = ["600519.SH", "700.HK", "AAPL.US"]

metrics = request_json(
    "calc_index_representative",
    "/v1/market/calc-index",
    {"symbols": ",".join(symbols), "type": "stock"},
    api_key,
)

for symbol in symbols:
    flow = request_json(
        f"capital_flow_{symbol.lower().replace('.', '_')}",
        "/v1/market/capital-flow",
        {"symbol": symbol, "type": "stock"},
        api_key,
    )
2026年7月21日22:47的真实返回如下:
| 市场 | 股票 | 5日变化 | 10日变化 | 量比 | PE TTM | 资金流分钟点数 |
|---|---|---|---|---|---|---|
| A股 | 贵州茅台 | 7.66% | 10.03% | 1.17 | 19.77 | 241 |
| 港股 | 腾讯控股 | 3.90% | 2.78% | 0.63 | 16.19 | 332 |
| 美股 | 苹果 | 3.84% | 5.25% | 0.99 | 39.18 | 77 |
三只股票的股票信息、ticker、K线、市场指标和资金流五项检查均通过,相关请求返回HTTP 200,结果为3/3 PASS。
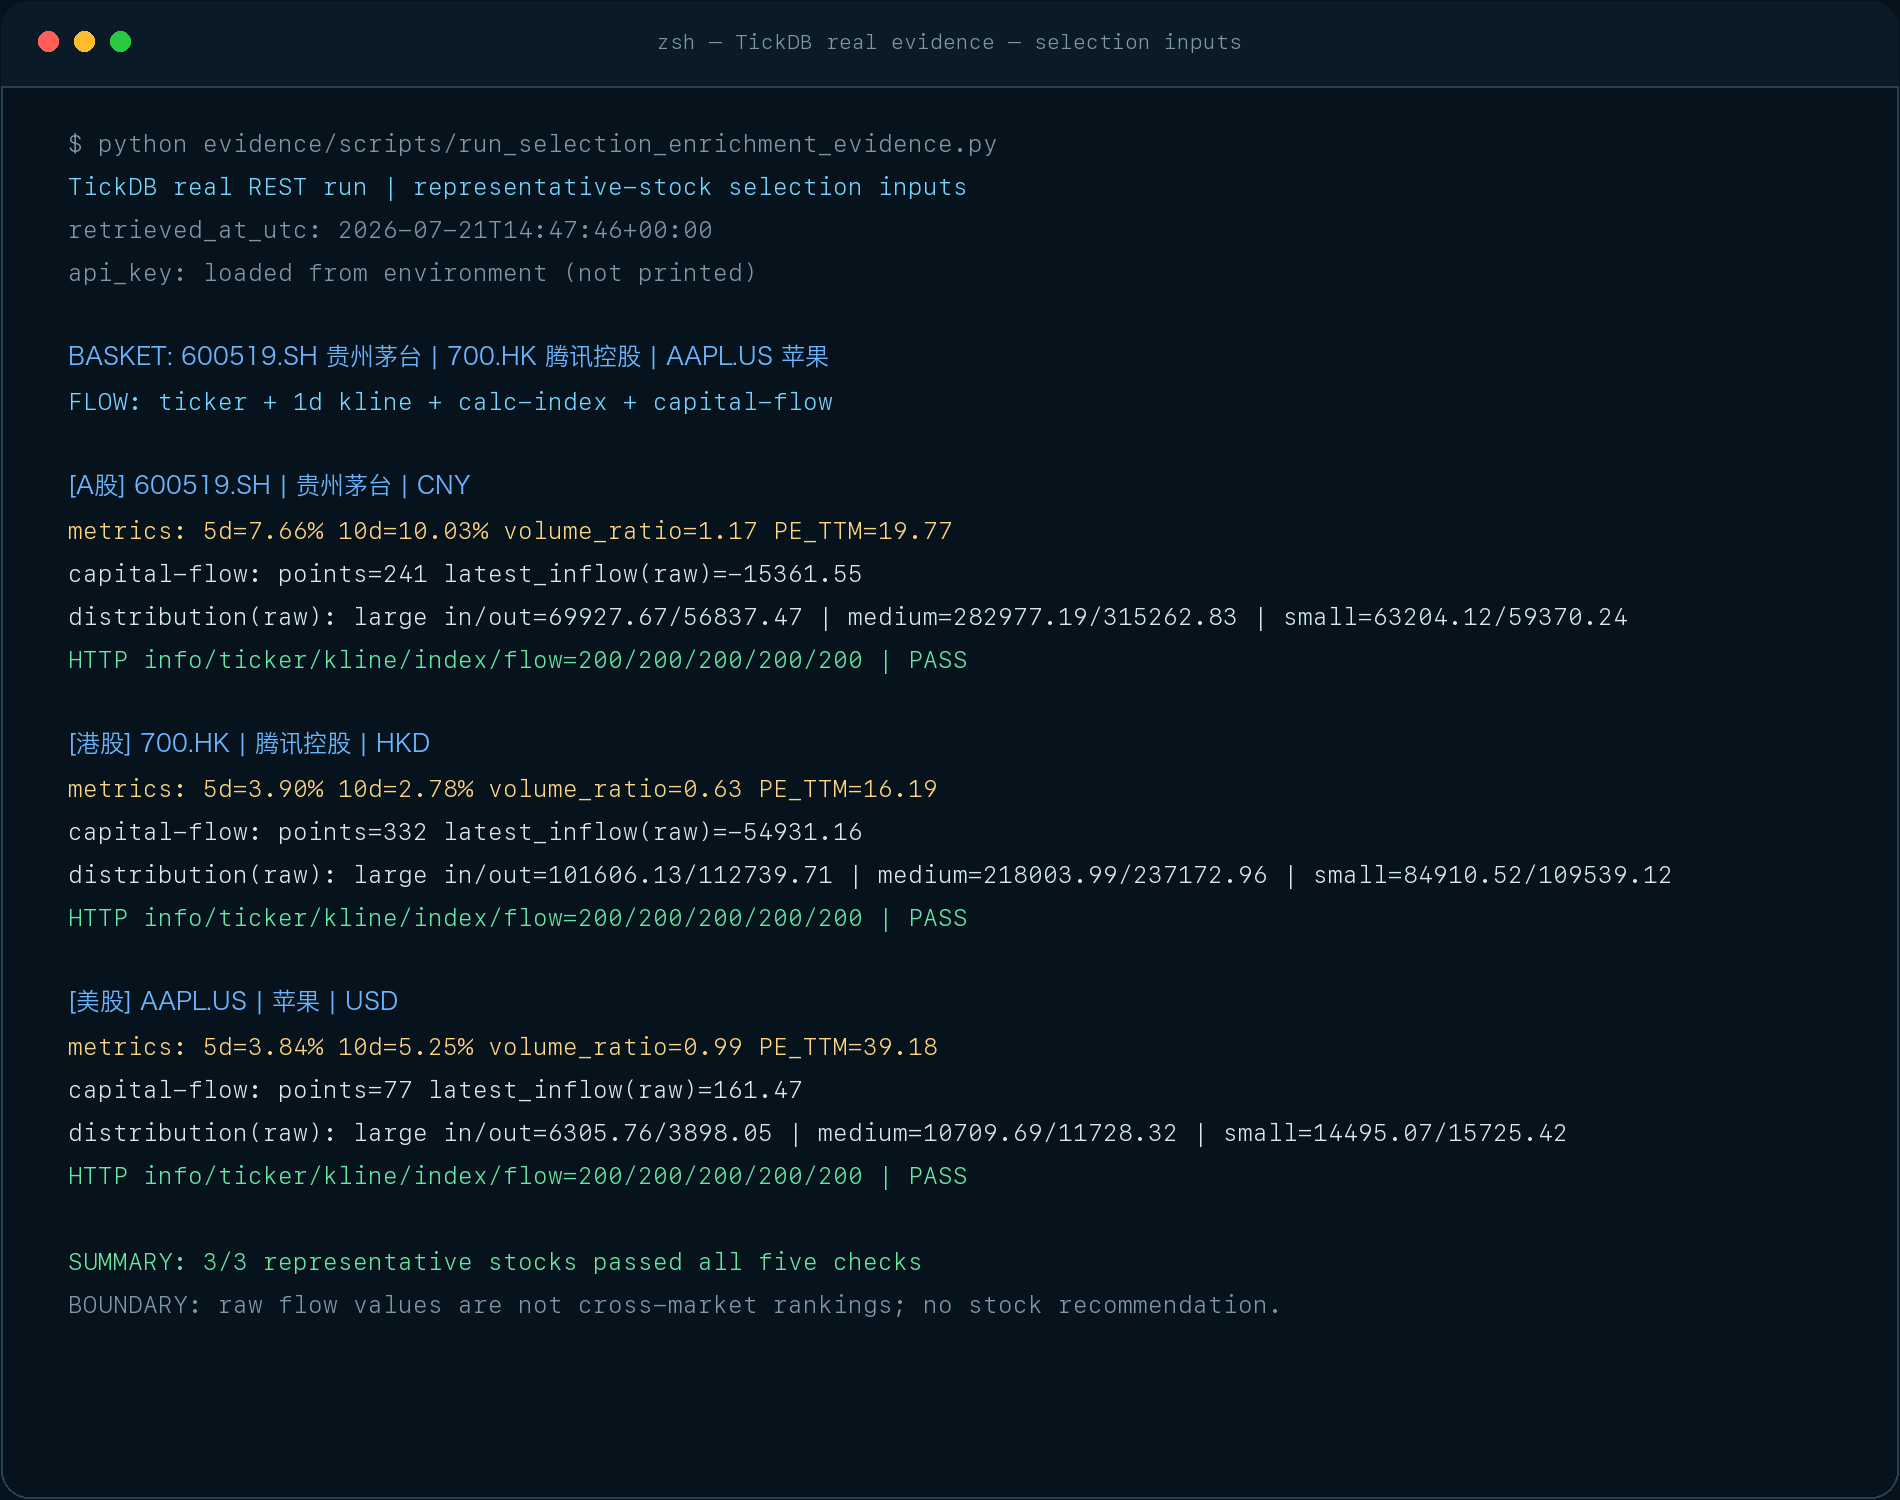 图注:2026-07-21 22:47 真实REST运行记录。图片只证明三个样本在本次调用中返回了ticker、K线、市场指标与资金流结构。资金流原始值不能直接跨市场排名,表中数据不构成选股结论或投资建议。
这次实测要证明的不是哪只股票更值得买,而是同一个symbol能继续进入行情、K线、综合指标和资金流任务。
一套接入,省下的不只是几个URL
多市场选股需要的不是一个“神奇指标”,而是一条连续的数据输入链:
产品目录建立扫描范围
→ ticker与K线确认行情
→ calc-index批量观察指标
→ capital-flow查看候选对象的资金结构
→ 用户规则完成筛选、排序与风险控制
TickDB不替用户选股票。它让A股、港股、美股的扫描对象、行情历史、辅助指标和资金流进入同一套REST API接入,减少重复维护名单、symbol映射和多套接口的工作。
名单不再是孤立的表,后续数据也不用分别生活在几套互不认识的系统里。
两条边界不能混
统一接入,不等于统一口径。
贵州茅台、腾讯控股和苹果分别使用CNY、HKD、USD。资金流原始值不能直接排名;估值指标也要结合市场、行业和公司阶段解释。币种换算、缺失值、分组和阈值仍由应用层处理。
当前目录,也不等于历史股票池。
今天能查到的股票,不能代表一年前、三年前的市场构成。历史选股仍需要对应日期的成分、上市状态和数据可用性证据,否则无法排除幸存者偏差。
最后检查四件事
在继续加因子前,先回答:
- 扫描名单从哪里来,多久更新一次?
- 目录中的symbol能否继续进入行情、K线和指标请求?
- 批量指标与单股资金流分别承担什么任务?
- 跨市场口径和历史样本由谁治理?
很多策略的平庸,是因为少看了一群人。
先保证该看的股票能进入扫描池,再决定先看谁、看多深。这个顺序,比继续堆指标更重要。
你现在的选股系统,是只有一份股票名单,还是已经把扫描池、综合指标和资金流拆成不同层?
公开资料:TickDB市场指标文档、TickDB资金流向文档、TickDB中文文档。
标签:多市场选股、行情API、市场指标、资金流向、A股、港股、美股、量化开发
风险提示:本文只讨论行情数据接入、辅助指标与资金流数据的工程使用,不推荐文中股票,不构成任何投资、交易或收益建议。